VS 채택률이 낮은 검색 집합 · 10/20–11/08 · 모르도르 스쿼드

VS 검색 10/20–11/08 · 뒤 기간(11/03 판 이후, 공급 2.7 을 받은 검색) 기준

검색 집합 10개의 채택률(KR1)이 23.4–28.6% 로, 나머지 검색보다 5.5–9.9%p 낮다

1YAML 라벨이 1개YAML
26.5%3,170건
2라벨의 항목이 0개YAML
28.6%3,358건
3표 없음 ∧ 상위 10 의 일부만 요구 유형YAML검색 결과
26.1%1,978건
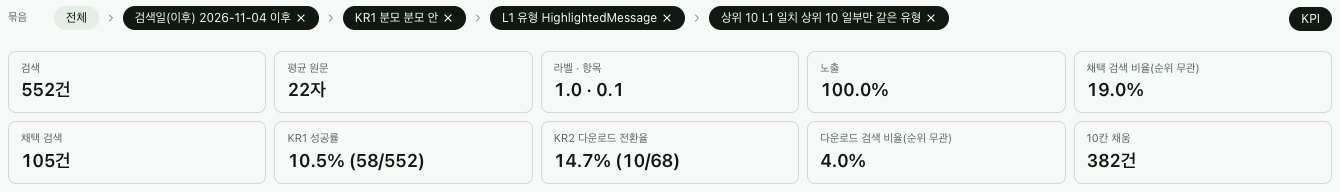
핵1 · 2 · 3 을 좁히면 모이는 곳 — TextBasedCommunication.HighlightedMessage ∧ 상위 10 의 일부만 같은 유형
10.6%670건
4라벨마다 항목이 3개YAML
26.6%595건
5원문 40–119자 ∧ 상위 10 에 Enumeration.ListingTable 노출원문검색 결과
23.4%376건
6추천 L1 있음 ∧ 같은 구조의 공급 없음검색 결과
26.4%568건
7Enumeration.ListingTable ∧ 표 1–3행YAML
27.7%602건
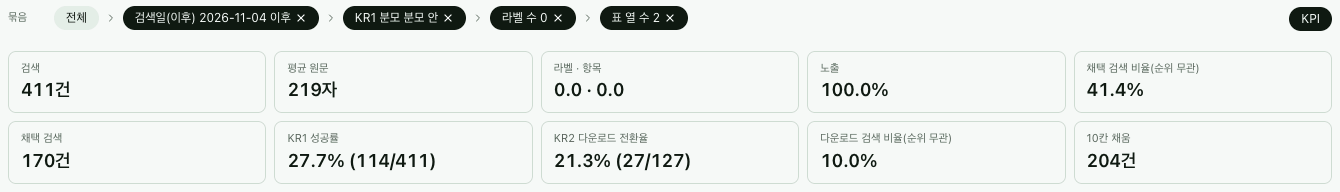
8라벨 0개 ∧ 표 2열YAML
27.8%504건
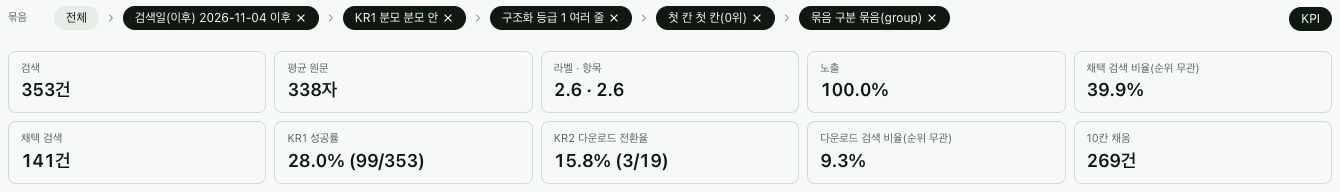
9여러 줄 원문 ∧ 첫 칸이 묶음(group)원문검색 결과
26.9%431건
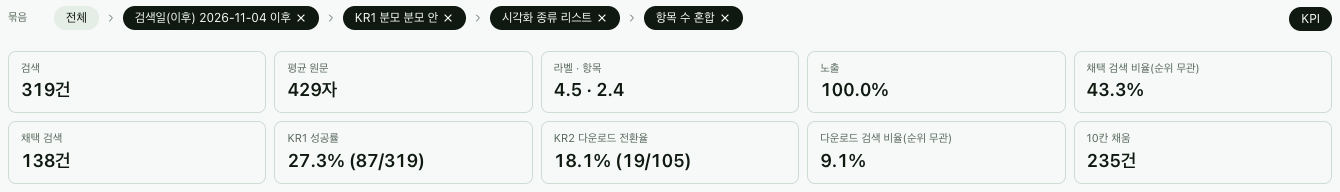
10list 선택 ∧ 라벨마다 항목 수가 다름원문YAML
26.6%372건
집합마다 뒤 기간 KR1 과 검색 수. 세로선은 뒤 기간 전체 KR1 33.0%(3,349/10,158). 1 · 2 · 3 은 검색의 50–66% 가 같아 값을 서로 더할 수 없다.

닿아 있는 단계원문YAML 생성검색 결과 모든 값은 상관이다. 집합의 속성이 채택을 낮춘다는 뜻이 아니다.

고른 방법

후보 1,121개 가운데 기준을 넘고 서로 다른 집합은 69개, 줄기로 묶으면 10개다

검정한 후보
1,121
1차원 81 · 2차원 1,040 — 검색 수 하한을 넘은 값과 조합
기준 통과
213
구간 · FDR · 차이 하한을 모두 넘음
중복 정리 뒤
69
부모보다 3%p 이상 낮지 않은 조합 144개를 뺌 (등급 A 58 · B 11)
줄기
10
겹치는 집합을 묶으면 11개, 기여도 순 10개를 실음
후보에서 줄기까지 남은 수. 막대 길이는 후보 수에 비례한다.
이 분석에서 정한 기준
검색 수 하한뒤 기간 ≥ 300건 그리고 전 기간 ≥ 1,000건
유의성뒤 기간 (집합 KR1 − 나머지 KR1) 의 95% 구간이 전부 0 미만, 그리고 FDR 5%
차이 하한나머지보다 5%p 이상 낮음
조합두 부모 각각보다 3%p 이상 낮을 때만 남김
앞 기간 · 옛 판
32.86%20,138건
뒤 기간 · 11/03 판
32.97%10,158건
판이 바뀐 앞뒤로 전체 KR1 은 32.86% 와 32.97% 다. 검색이 실제로 받은 판으로 기간을 갈랐다.

원문3

원문 길이 · 구조화 등급 · 시각화 종류(유저 선택)

YAML5

L1 유형 · 라벨 수 · 항목 수 · 표 행 수 · 표 열 수

검색 결과13

rec:L1 · 1순위 매칭 · 상위 10 채움 · 상위 10 L1 일치 · 표·차트 L1 의 상위 10 · 상위 10 노출 유형 · 상위 10 묶음 구분 · 상위 10 장 수 · 첫 칸 유형 · 첫 칸 묶음 구분 · 첫 칸 장 수 · 구조 일치 공급 상태 · 필터 통과 후보 수(tier1)

집합을 가른 축 21개. 채택 결과에서 나온 축은 쓰지 않았다.

KR1 = 상위 10 칸 안에서 채택이 난 검색 ÷ KPI 대상이면서 상위 10 에 한 칸 이상 노출된 검색.

집합 1 · 2 · 3원문YAML검색 결과등급 A · 두 기간 모두 낮음

세 집합은 좁히면 같은 곳에 닿는다 — 라벨 1개 · 항목 0개인 TextBasedCommunication.HighlightedMessage 에서 KR1 10.6%

세 뿌리: labels:1 / items:0 / rows:none ∧ l1match:part · 좁힌 곳: l1type:TextBasedCommunication.HighlightedMessage ∧ l1match:part 모양: 한 줄 입력 → label 1개 · items 0개 · dataset 없음

뿌리 1 · 라벨 1개앞 기간 24.5%
26.5%3,170건
+ 상위 10 의 일부만 같은 유형앞 기간 18.2%
21.1%1,200건
+ 유형앞 기간 12.1%
10.6%670건
뿌리 2 · 항목 0개앞 기간 26.6%
28.6%3,358건
+ 상위 10 의 일부만 같은 유형앞 기간 18.6%
25.2%1,350건
+ 유형앞 기간 11.1%
9.9%639건
뿌리 3 · 표 없음 ∧ 상위 10 의 일부만 같은 유형앞 기간 24.4%
26.1%1,978건
+ 유형앞 기간 12.1%
10.6%670건
뿌리가 달라도 좁히면 같은 검색 670건 안팎에 닿는다. 「+ 유형」 = L1 유형이 TextBasedCommunication.HighlightedMessage. 세 뿌리는 검색의 50–66% 를 공유한다. 마지막 단(3차원)은 FDR 보정 밖이다.
집합나머지 검색
앞 기간1,573건
12.1% 대 34.6%−22.5%p [−24.1, −20.6]
뒤 기간670건
10.6% 대 34.5%−23.9%p [−26.3, −21.2]
상위 10 에 미분류 컴포넌트 노출
집합
96.9%
나머지
8.6%
원문 10자 미만
집합
39.1%
나머지
0.5%
좁힌 곳(TextBasedCommunication.HighlightedMessage ∧ 상위 10 의 일부만 같은 유형)은 두 기간 모두 나머지보다 20%p 넘게 낮다.
수요 분석 화면 탐색 탭 집계 타일: 좁힌 집합의 뒤 기간 검색 수와 KR1
탐색 탭 · 11/04 이후 필터 · 화면 표시값 10.5% (58/552). 화면은 날짜로 가르므로 11/03 의 새 판 검색이 빠져 분석값 10.6% (71/670) 과 다르다. 운영 화면에서 열기

라벨 1개 · 항목 0개 YAML 은 짧은 한 줄 원문에서 주로 나오고 원문 길이 · 등급과 얽혀 있어, 어느 속성의 몫인지 가르지 못한다. 미분류 컴포넌트는 새 판에만 있어 앞 기간 비교가 없다.

집합 4YAML등급 A · 두 기간 모두 낮음

라벨마다 항목이 3개인 YAML 은 KR1 26.6%, 구조가 같은 컴포넌트가 노출된 검색으로 좁히면 22.9%

L1 YAML 의 모든 라벨이 항목을 3개씩 가진 검색 · items:3 모양: 라벨 n개 × 항목 3개

라벨마다 항목 3개
26.6%595건
+ 원문 120–299자
23.5%430건
+ 구조 일치 컴포넌트가 상위 10 에 노출화면에서 다시 만들 수 없음
22.9%341건
좁힐수록 KR1 이 낮아진다. 가장 좁은 단은 분석 파일 기준이다.
집합나머지 검색
앞 기간1,220건
29.3% 대 33.1%−3.8%p [−6.3, −1.1]
뒤 기간595건
26.6% 대 33.4%−6.8%p [−10.3, −3.0]
구조 일치 컴포넌트가 상위 10 에 노출
집합
57.3%
나머지
43.2%
구조 일치 공급 없음
집합
1.8%
나머지
15.6%
뒤 기간 차이 −6.8%p [−10.3, −3.0], 앞 기간 −3.8%p [−6.3, −1.1].
수요 분석 화면 탐색 탭 집계 타일: 이 집합의 뒤 기간 검색 수와 KR1
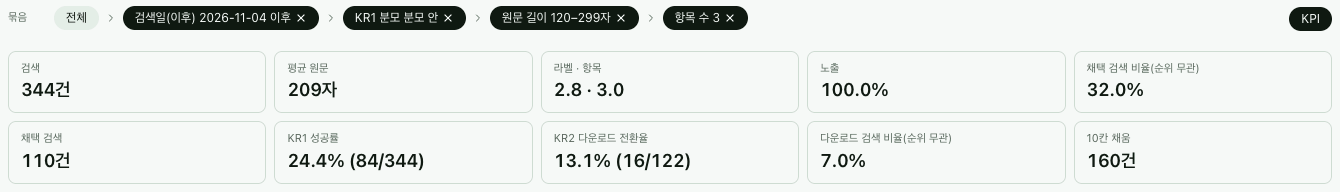
탐색 탭 · 11/04 이후 필터 · len:120–299 ∧ items:3 · 화면 표시값 24.4% (84/344). 화면은 날짜로 가르므로 분석값 23.5% (101/430) 과 다르다. 가장 좁은 단은 화면에서 다시 만들 수 없다. 운영 화면에서 열기

항목 3개는 120–299자 원문과 특정 L1 유형에 몰릴 수 있다. 구조가 같은 컴포넌트가 노출된 검색에서 더 낮은 까닭은 이 자료로 가르지 못한다. 구조 일치 축의 앞 기간 값은 새 판 공급을 기준으로 한 가정값이다.

집합 5원문검색 결과등급 A · 두 기간 모두 낮음

40–119자 원문에 Enumeration.ListingTable 이 노출된 검색은 KR1 23.4%

원문이 40–119자이고 상위 10 칸에 Enumeration.ListingTable 유형 컴포넌트가 노출된 검색 · len:40–119 ∧ ctype10:Enumeration.ListingTable 모양: 짧은 원문 → 상위 10 에 Enumeration.ListingTable

원문 40–119자 ∧ 상위 10 에 Enumeration.ListingTable 노출
23.4%376건
원문 40–119자 ∧ L1 유형이 Enumeration.ListingTable
22.6%371건
노출 기준으로 잡아도 YAML 유형 기준으로 잡아도 검색의 96% 가 같다.
집합나머지 검색
앞 기간736건
30.7% 대 33.0%−2.2%p [−5.5, +1.2]
뒤 기간376건
23.4% 대 33.3%−9.9%p [−14.0, −5.3]
구조가 같은 후보가 통과했지만 상위 10 에 없음
집합
54.5%
나머지
24.7%
구조 일치 컴포넌트가 상위 10 에 노출
집합
39.9%
나머지
44.2%
뒤 기간 차이 −9.9%p [−14.0, −5.3], 앞 기간 −2.2%p [−5.5, +1.2].
수요 분석 화면 탐색 탭 집계 타일: 이 집합의 뒤 기간 검색 수와 KR1
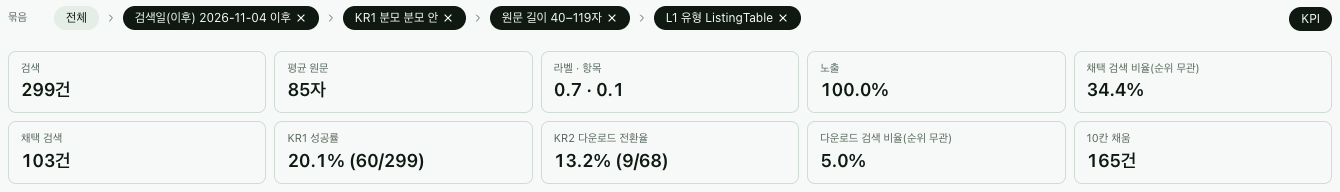
탐색 탭 · 11/04 이후 필터 · len:40–119 ∧ l1type:Enumeration.ListingTable · 화면 표시값 20.1% (60/299). 화면은 날짜로 가르므로 분석값 22.6% (84/371) 과 다르다. 운영 화면에서 열기

표를 고른 유저의 비중과, 표에 채울 내용이 적은 입력이 섞여 있을 수 있다.

집합 6검색 결과등급 A · 두 기간 모두 낮음

추천 L1 이 있고 같은 구조의 공급이 없는 검색은 KR1 26.4%

생성 결과에 추천 L1 YAML(rec:L1)이 함께 있고, 그 구조와 같은 컴포넌트가 공급에 없는 검색 · rec:true ∧ struct:① 공급 없음 모양: 추천 L1 있음 · 같은 구조의 컴포넌트 0개

추천 L1 있음 ∧ 구조 일치 공급 없음
26.4%568건
집합 하나로 선 줄기다. 더 좁은 집합은 기준을 넘지 못했다.
집합나머지 검색
앞 기간1,141건
29.0% 대 33.1%−4.1%p [−6.7, −1.3]
뒤 기간568건
26.4% 대 33.4%−7.0%p [−10.5, −3.1]
상위 10 에 요구 유형과 같은 유형이 없음
집합
13.0%
나머지
5.1%
뒤 기간 차이 −7.0%p [−10.5, −3.1], 앞 기간 −4.1%p [−6.7, −1.3].
수요 분석 화면 구조 탐색 탭: 구조 일치 후보가 없는 검색 수 막대
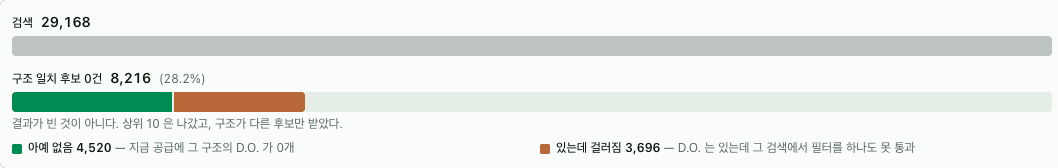
구조 탐색 탭(전 기간, 기간 필터와 KR1 없음). 이 집합은 분석 파일의 구조 일치 공급 상태로 만든 것이라 화면에서 같은 수치를 다시 만들 수 없다(분석 파일 기준). 운영 화면의 구조 탐색 탭 열기

공급이 없는 구조는 항목 수가 많거나 고르지 않은 입력에 몰려 입력 난이도와 얽힌다. 구조 일치 축의 앞 기간 값은 새 판 공급을 기준으로 한 가정값이라 앞 기간 방향은 참고값이다.

집합 7YAML등급 B · 새 판에서 낮아짐

Enumeration.ListingTable 에 표가 1–3행인 검색은 KR1 27.7% — 앞 기간에는 36.2% 였다

L1 유형이 Enumeration.ListingTable 이고 dataset 행이 1–3개인 검색 · l1type:Enumeration.ListingTable ∧ rows:1–3 모양: 표 1–3행

Enumeration.ListingTable ∧ 표 1–3행
27.7%602건
라벨 0개 ∧ 표 1–3행
27.5%411건
두 정의는 검색의 76% 를 공유한다.
집합나머지 검색
앞 기간1,181건
36.2% 대 32.6%+3.6%p [+0.8, +6.5]
뒤 기간602건
27.7% 대 33.3%−5.6%p [−9.1, −1.7]
구조가 같은 후보가 통과했지만 상위 10 에 없음
집합
60.1%
나머지
23.6%
뒤 기간 차이 −5.6%p [−9.1, −1.7], 앞 기간 +3.6%p [+0.8, +6.5].
수요 분석 화면 탐색 탭 집계 타일: 이 집합의 뒤 기간 검색 수와 KR1
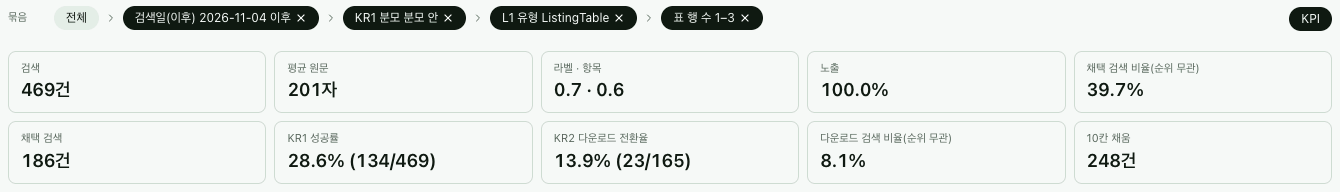
탐색 탭 · 11/04 이후 필터 · 화면 표시값 28.6% (134/469). 화면은 날짜로 가르므로 분석값 27.7% (167/602) 과 다르다. 운영 화면에서 열기

행이 1–3개인 표는 내용이 적은 입력이다. 앞 기간에는 낮지 않았으므로, 판 변경과 같은 때의 다른 변화(유저 구성 · 요일)와 가르지 못한다.

집합 8YAML등급 B · 새 판에서 낮아짐

라벨 없이 표가 2열인 검색은 KR1 27.8% — 앞 기간에는 39.7% 였다

L1 YAML 에 라벨이 없고 dataset 이 2열인 검색 · labels:0 ∧ cols:2 모양: 라벨 0개 · 표 2열

라벨 0개 ∧ 표 2열
27.8%504건
집합 하나로 선 줄기다.
집합나머지 검색
앞 기간942건
39.7% 대 32.5%+7.2%p [+4.0, +10.4]
뒤 기간504건
27.8% 대 33.2%−5.5%p [−9.3, −1.3]
구조가 같은 후보가 통과했지만 상위 10 에 없음
집합
50.6%
나머지
24.5%
뒤 기간 차이 −5.5%p [−9.3, −1.3], 앞 기간 +7.2%p [+4.0, +10.4].
수요 분석 화면 탐색 탭 집계 타일: 이 집합의 뒤 기간 검색 수와 KR1
탐색 탭 · 11/04 이후 필터 · 화면 표시값 27.7% (114/411). 화면은 날짜로 가르므로 분석값 27.8% (140/504) 과 다르다. 운영 화면에서 열기

앞 기간에는 낮지 않았다. 뒤 기간 검색이 500건 안팎이라 구간 위쪽 끝이 0 에 가깝다.

집합 9원문검색 결과등급 A · 두 기간 모두 낮음

여러 줄 원문에 첫 칸이 묶음으로 나온 검색은 KR1 26.9%

원문이 여러 줄(불릿 · 표 없음)이고 첫 칸이 2장 묶음(group)인 검색 · grade:1 ∧ first.entrykind:group 모양: 여러 줄 입력 → 첫 칸이 2장 묶음

여러 줄 원문 ∧ 첫 칸이 묶음
26.9%431건
집합 하나로 선 줄기다. 첫 칸이 2장인 검색으로 잡아도 같은 집합이다.
집합나머지 검색
앞 기간777건
30.4% 대 33.0%−2.6%p [−5.8, +0.8]
뒤 기간431건
26.9% 대 33.2%−6.3%p [−10.4, −1.9]
상위 10 에 요구 유형과 같은 유형이 없음
집합
16.9%
나머지
5.0%
구조가 같은 후보가 필터에서 탈락
집합
31.6%
나머지
11.5%
뒤 기간 차이 −6.3%p [−10.4, −1.9], 앞 기간 −2.6%p [−5.8, +0.8].
수요 분석 화면 탐색 탭 집계 타일: 이 집합의 뒤 기간 검색 수와 KR1
탐색 탭 · 11/04 이후 필터 · 화면 표시값 28.0% (99/353). 화면은 날짜로 가르므로 분석값 26.9% (116/431) 과 다르다. 운영 화면에서 열기

첫 칸이 묶음인지는 검색 로직이 정하지만, 묶음이 나오는 입력(여러 줄 원문 가운데 내용이 많은 것)의 성격과 얽힌다.

집합 10원문YAML등급 A · 두 기간 모두 낮음

list 를 고르고 라벨마다 항목 수가 다른 YAML 은 KR1 26.6%

유저가 시각화 종류로 list 를 골랐고, L1 YAML 의 라벨마다 항목 수가 다른 검색 · kind:list ∧ items:mixed 모양: 라벨마다 항목 수가 다름(예: 2 · 1 · 3)

list 선택 ∧ 항목 수가 고르지 않음
26.6%372건
집합 하나로 선 줄기다.
집합나머지 검색
앞 기간660건
29.7% 대 33.0%−3.3%p [−6.7, +0.4]
뒤 기간372건
26.6% 대 33.2%−6.6%p [−10.9, −1.8]
구조 일치 공급 없음
집합
50.8%
나머지
13.4%
구조가 같은 후보가 필터에서 탈락
집합
24.2%
나머지
11.9%
뒤 기간 차이 −6.6%p [−10.9, −1.8], 앞 기간 −3.3%p [−6.7, +0.4].
수요 분석 화면 탐색 탭 집계 타일: 이 집합의 뒤 기간 검색 수와 KR1
탐색 탭 · 11/04 이후 필터 · 화면 표시값 27.3% (87/319). 화면은 날짜로 가르므로 분석값 26.6% (99/372) 과 다르다. 운영 화면에서 열기

고르지 않은 구조는 길고 복잡한 원문에서 나오므로 입력 난이도와 얽힌다.

부록 1 · 해소된 것

앞 기간에만 기준을 넘던 집합 8개 — 뒤 기간에 0 이상으로 돌아선 것은 MagnitudeRanking.BarChart 노출 하나다

상위 10 에 MagnitudeRanking.BarChart 노출ctype10:MagnitudeRanking.BarChart
−16.4 → +3.4%p뒤 417건 · 36.2%
상위 10 의 일부만 요구 유형l1match:part
−8.1 → −4.4%p뒤 2,672건 · 29.7%
상위 10 칸을 전부 봄top10fill:10
−5.2 → −4.3%p뒤 6,585건 · 31.4%
표 행 없음rows:none
−5.2 → −1.6%p뒤 6,729건 · 32.4%
표 열 없음cols:none
−5.1 → −1.6%p뒤 6,720건 · 32.4%
Enumeration.List ∧ 구조 일치 공급 없음l1type:Enumeration.List ∧ struct:① 공급 없음
−8.7 → −4.1%p뒤 707건 · 29.1%
라벨 2개 ∧ 추천 L1 있음labels:2 ∧ rec:true
−7.0 → −3.0%p뒤 429건 · 30.1%
원문 40–119자 ∧ 구조 같은 후보가 상위 10 에 없음len:40–119 ∧ struct:③ 통과했지만 상위 10 에 구조 일치 없음
−6.0 → −4.0%p뒤 576건 · 29.2%
앞 기간 차이뒤 기간 차이차이 = 집합 KR1 − 나머지 KR1
상위 10 에 MagnitudeRanking.BarChart 가 노출된 검색은 KR1 이 18.2% 에서 36.2% 가 됐다. 나머지 일곱은 뒤 기간에도 음수지만 −5%p 에 못 미치거나 구간이 0 을 포함한다.

부록 2 · 하한 미달로 빠진 것

뒤 기간 검색이 200–299건이라 빠졌지만 나머지보다 10%p 이상 낮은 집합이 5개 있다

라벨 4개 ∧ 라벨마다 항목 3개labels:4 ∧ items:3
17.5%228건
첫 칸이 미분류 컴포넌트first.ctype:(미분류)
20.8%216건
첫 칸이 TextBasedCommunication.LongFormTextLayout ∧ 구조 같은 후보가 상위 10 에 없음first.ctype:TextBasedCommunication.LongFormTextLayout ∧ struct:③ 통과했지만 상위 10 에 구조 일치 없음
21.6%269건
원문 40–119자 ∧ 라벨 0개len:40–119 ∧ labels:0
21.9%228건
상위 10 전부 요구 유형 ∧ 첫 칸이 TextBasedCommunication.LongFormTextLayoutl1match:all ∧ first.ctype:TextBasedCommunication.LongFormTextLayout
22.1%267건
검색 수 하한(뒤 기간 300건)에 못 미쳐 본문에서 빠진 집합의 뒤 기간 KR1. 다중 비교 보정 밖이다.

같은 범위의 조합이 23개 더 있다. 부모와 3%p 차이가 나지 않는 것들로, 대부분 원문 10자 미만 검색(뒤 기간 314건)에 다른 축을 얹은 것이다.

부록 3 · 한계와 판정 기준 메모

모든 값은 상관이고, 검색 결과 축에는 유저 행동이 섞여 있다

한계

  1. 상관이다. 집합이 낮다는 것은 그 속성이 채택을 낮춘다는 뜻이 아니다. 집합마다 얽힌 요인을 한 줄씩 적었다.
  2. 검색 결과 축에는 유저 행동이 섞인다. 「노출」은 유저가 실제로 본 칸으로 센다. 칸이 없어서 못 채운 것과 유저가 덜 내려간 것을 가르지 못한다.
  3. 구조 축의 앞 기간 값은 가정값이다. 구조 일치 공급 상태는 새 판 공급을 기준으로 계산했고, 원문 10자 이상 검색에만 있다. 화면에서 다시 만들 수 없다.
  4. 미분류 컴포넌트의 분류 누락 여부는 확인하지 못했다. 뒤 기간 상위 10 칸 가운데 미분류는 1,627칸(컴포넌트 141개)이고 앞 기간은 4칸이다.
  5. 뒤 기간은 엿새치다. 검색 10,158건. 300건짜리 집합의 차이 구간 폭은 ±5%p 안팎이다.

판정 기준을 계산으로 옮기며 정한 것

  • 두 비율 검정은 합동 분산 z 검정(양측), 구간은 Newcombe 95%.
  • FDR 은 1차원 + 2차원 후보 1,121개에 Benjamini–Hochberg 5% 로 걸었다. 3차원 단과 하한 미달 목록은 보정 밖이다.
  • 구성 검색이 완전히 같은 후보는 하나로 셌다.
  • 뒤 기간 검색을 작은 쪽 기준 70% 이상 공유하면 같은 줄기로 묶었다. 1 · 2 · 3 은 50–66% 라 따로 섰다.
  • 등급 A = 앞 기간에도 나머지보다 낮음, B = 앞 기간에는 낮지 않음.
  • 기여도 = 검색 비중 × (집합 KR1 − 전체 KR1). 겹치는 집합끼리는 더하지 않는다.
  • 후보끼리 크게 겹치므로 통과 수는 독립된 발견의 수가 아니다.